ハルシネーションとは?ChatGPTがもっともらしい嘘をつく理由
2026年11月13日
この記事の要点
- ハルシネーションは、ChatGPTなどのAIが、事実と違う内容をもっともらしい文章で答えてしまう現象です
- AIは「次に来そうな言葉」を予測して文章を作るため、型から予測できない細かな事実で間違いが起きます
- OpenAIは2026年10月、誤りが起きやすい質問での評価で、GPT-6の正確さがほぼすべての指標で前のモデルより改善したと説明しています
ChatGPTなどのAIに質問すると、実在しない本の名前や間違った日付が、自信ありげな文章で返ってくることがあります。この現象が「ハルシネーション(hallucination)」です。もとは英語で「幻覚」を意味する言葉です。
この記事では、なぜ起きるのかをたとえ話で説明します(2026年11月時点)。
ハルシネーションとは:もっともらしいのに事実と違う答え
ChatGPTを開発したOpenAIは、2025年9月5日に研究の紹介記事を出しました。その中でハルシネーションを、言語モデルが作り出す「もっともらしいが誤った記述」と説明しています。
同社のヘルプページは、例として次のものを挙げています。
- 定義や日付、事実の間違い
- 作り上げられた引用や研究、実在しない資料への言及
- あいまいな質問や複雑な質問への、自信過剰な答え
紹介記事にも例があります。広く使われているチャットAIに、この研究の著者の一人の博士論文の題名をたずねたところ、自信ありげな答えが3通り返ってきました。どれも正しくなかったといいます。
たとえるなら:何も見ずに話す、物知りな人
本をたくさん読んできた、物知りな人を思い浮かべてください。この人は資料を何も見ず、覚えている言葉のつながりだけで話します。
よく知っている話なら、すらすらと正しく答えます。けれども、うろ覚えの話でも同じ調子で話を続けます。聞いている側には、どこからがうろ覚えなのか、口ぶりからは分かりません。
文章を作るAIは、この物知りな人に似ています。大量の文章を使い、「次に来そうな言葉」を予測する練習から学び始めるからです。
OpenAIによると、練習に使う文章には、正しいか誤りかの印が付いていません。つづりや括弧の使い方のように決まった型があるものは、規模が大きくなると間違いが消えていきます。一方で、誕生日のように型から予測できない細かな事実は、間違いのもとになります。
なぜ「分かりません」と言わないのか
OpenAIの研究チームは、理由をテストの採点にたとえています。選択式のテストでは、分からない問題でも、当てずっぽうで答えれば正解することがあります。空欄のままなら、必ず0点です。
AIの性能を比べる成績表の多くも、正解した割合を重視して順位を付けています。そのため、「分かりません」と答えるAIより、推測で答えるAIのほうが成績表の上では良く見えます。
同社は、こうした学習と評価の進め方が、分からないと認めることより推測することに報いてきたと論じています。
実際に起きたこと:裁判所に出された実在しない判例
米国ニューヨークの連邦地方裁判所で2023年、弁護士が出した書面に、実在しない判例が引用されていたことが分かりました。判例はChatGPTが作り出したものでした。
裁判所の命令によると、調べものをした弁護士は、ChatGPTを「すごい検索エンジンのようなもの」だと思い込んでいたと述べています。
裁判所は2023年6月22日、弁護士2人と所属する法律事務所に、5,000ドルの制裁金を科しました。判事は命令の中で、信頼できるAIを助けとして使うこと自体は不適切ではないと書いています。そのうえで、提出する書面の正確さを確かめる役割は弁護士にあるとしました。
同じような例は、その後も続いています。こうした例を集めた公開のデータベースがあります。作っているのは、法律の分野でのAIを研究するダミアン・シャルロタン(Damien Charlotin)氏です。同氏は、フランスの経営大学院HEC Parisの上級研究員を務めています。対象は、AIが作り出したとされる架空の内容について、各国の裁判所などが判断を示したものです。2026年11月12日時点で2,292件あり、うち米国が1,553件です。
2026年6月8日には、米国ミシシッピ州の連邦地方裁判所が、弁護士4人に制裁を科しました。原告側と被告側の両方の書面に、実在しない判例が引用されていたためです。
裁判所が命令で挙げた実在しない判例の引用は、合わせて6件です。書面を作った弁護士は、AIが出した判例を確かめていませんでした。制裁金は4人の合計で8,000ドルです。4人とも、この裁判の担当から外されました。
よくある勘違い
ここでは、ハルシネーションについての勘違いを3つ取り上げます。
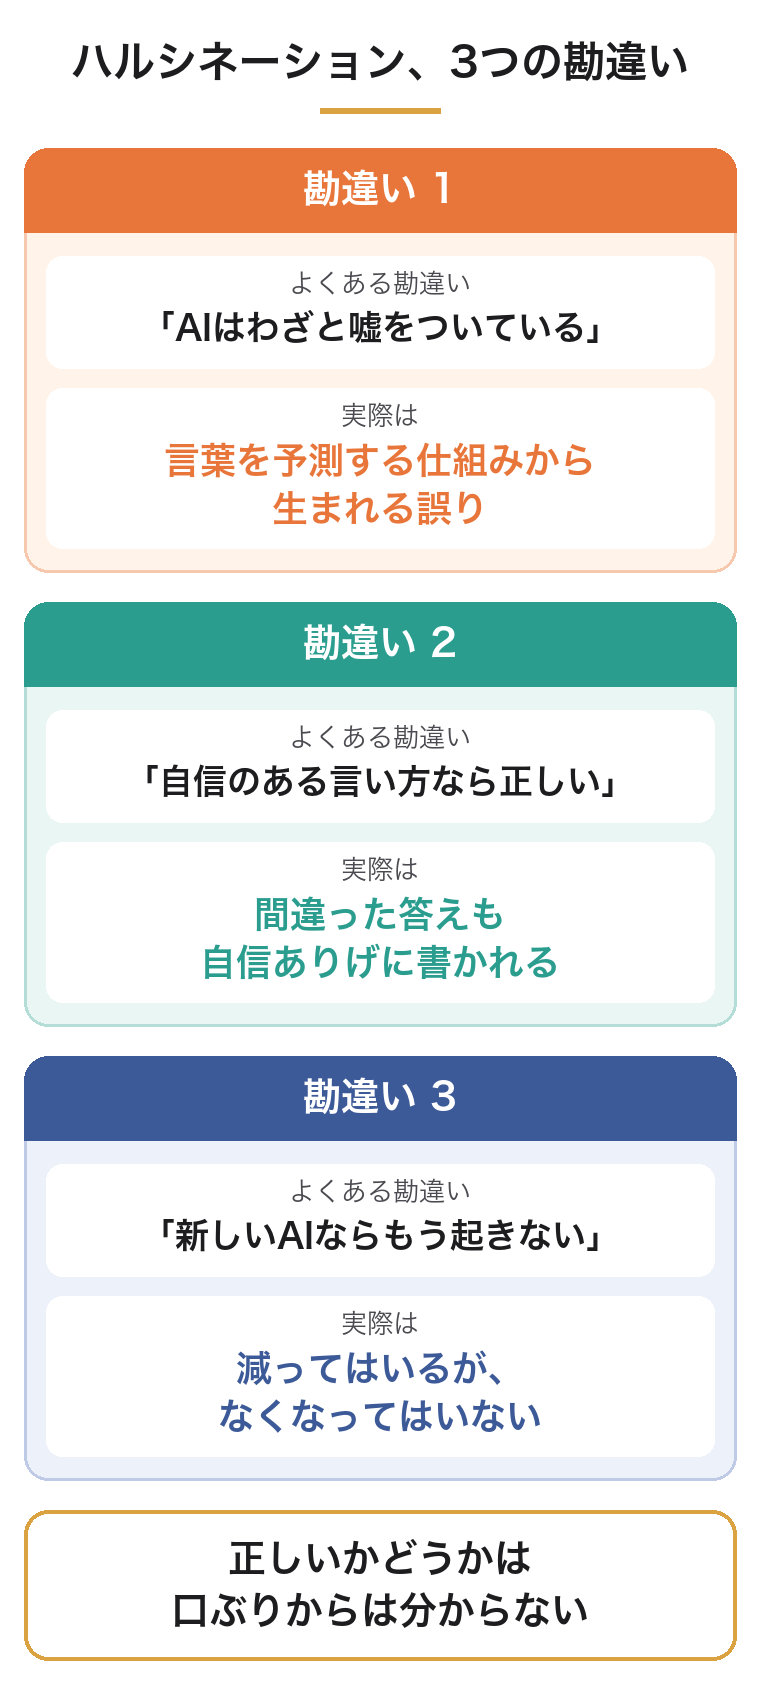
1つ目について、米国立標準技術研究所(NIST:National Institute of Standards and Technology)は2024年7月の文書で、言葉を予測して文章を作るという設計から自然に生じる結果だと説明しています。2つ目について、OpenAIのヘルプページは、間違った答えでも高い自信を示すことがあると書いています。
3つ目について、OpenAIは2026年10月7日、GPT-6をChatGPTの全利用者に提供する際の文書を出しました。その中で、事実の正確さは、ほぼすべての指標で前のモデルより大きく改善したと書いています。
同じ文書によると、同社は間違いが起きやすい質問を選び、誤りの割合を測っています。医療・法律・お金の難しい質問も、その中に含まれます。2025年9月の紹介記事では、ハルシネーションはすべての大規模言語モデルに共通する課題だと説明していました。
減らすための工夫もあります。ChatGPTには、ウェブを検索し、出典を付けて答える機能が用意されています。物知りな人のたとえでいえば、資料を見ながら答えてもらう形です。
Claudeを開発するAnthropicは、開発者向けの文書で、AIに「分かりません」と答えてよいと伝える方法などを紹介しています。あわせて、こうした方法でも完全にはなくならないと書いています。OpenAIも利用者に、重要な情報は信頼できる情報源で確かめるよう呼びかけています。
関連する言葉
- 大規模言語モデル(LLM:Large Language Model):大量の文章から学び、次に来そうな言葉を予測して文章を作るAIの仕組み
- コンファビュレーション(作話、英語:confabulation):NISTが、この現象を指すときに使っている呼び名。ハルシネーションは通称という扱い
- ナレッジカットオフ(英語:knowledge cutoff):AIが学んだデータの最終時点。それより後の出来事は、検索などの機能を使わない限り、AIが学んだ知識には含まれない
- ほかの言葉の解説は、「今さら聞けないAIの言葉」の一覧にまとめています
まとめ
ハルシネーションは、AIが事実と違う内容をもっともらしく答えてしまう現象です。
背景には、次に来そうな言葉を予測して文章を作る仕組みと、推測で答えたほうが良く見える採点の仕方があります。OpenAIは2026年10月、誤りが起きやすい質問を使った評価の結果を公表しました。GPT-6の事実の正確さは、ほぼすべての指標で前のモデルより改善したと説明しています。
情報源
OpenAI – Why language models hallucinate
OpenAI Help Center – Does ChatGPT tell the truth?
U.S. District Court, S.D.N.Y. – Mata v. Avianca, Inc., Opinion and Order on Sanctions
OpenAI – GPT-6 Sol and GPT-6 Luna: October 2026 update
Damien Charlotin – AI Hallucination Cases Database
Damien Charlotin – Curriculum Vitae
U.S. District Court, N.D. Miss. – Withers v. City of Aberdeen, Sanctions Order
Anthropic – Reduce hallucinations
当社のメールマガジンでは、シリコンバレーの最新トレンドやビジネス戦略に関する情報を発信しています。メルマガをご希望の方は、こちらのサイトからご登録ください。